
Die Ausgangslage
Vertrags- und Instandhaltungsteams verbringen Stunden damit, eine einzelne Klausel in hunderten PDFs zu finden – und ein allgemeines Chat-Modell kommt nicht infrage: Die Dokumente sind vertraulich, die Antworten müssen nachweisbar stimmen, und „ich glaube, drei Monate“ ist schlechter als gar keine Antwort.
Wir wollten einen Assistenten bauen, der ausschließlich aus den ihm gegebenen Dokumenten spricht, genau zeigt, woher eine Antwort stammt, und vollständig in der eigenen Infrastruktur des Unternehmens läuft.
Was wir gebaut haben
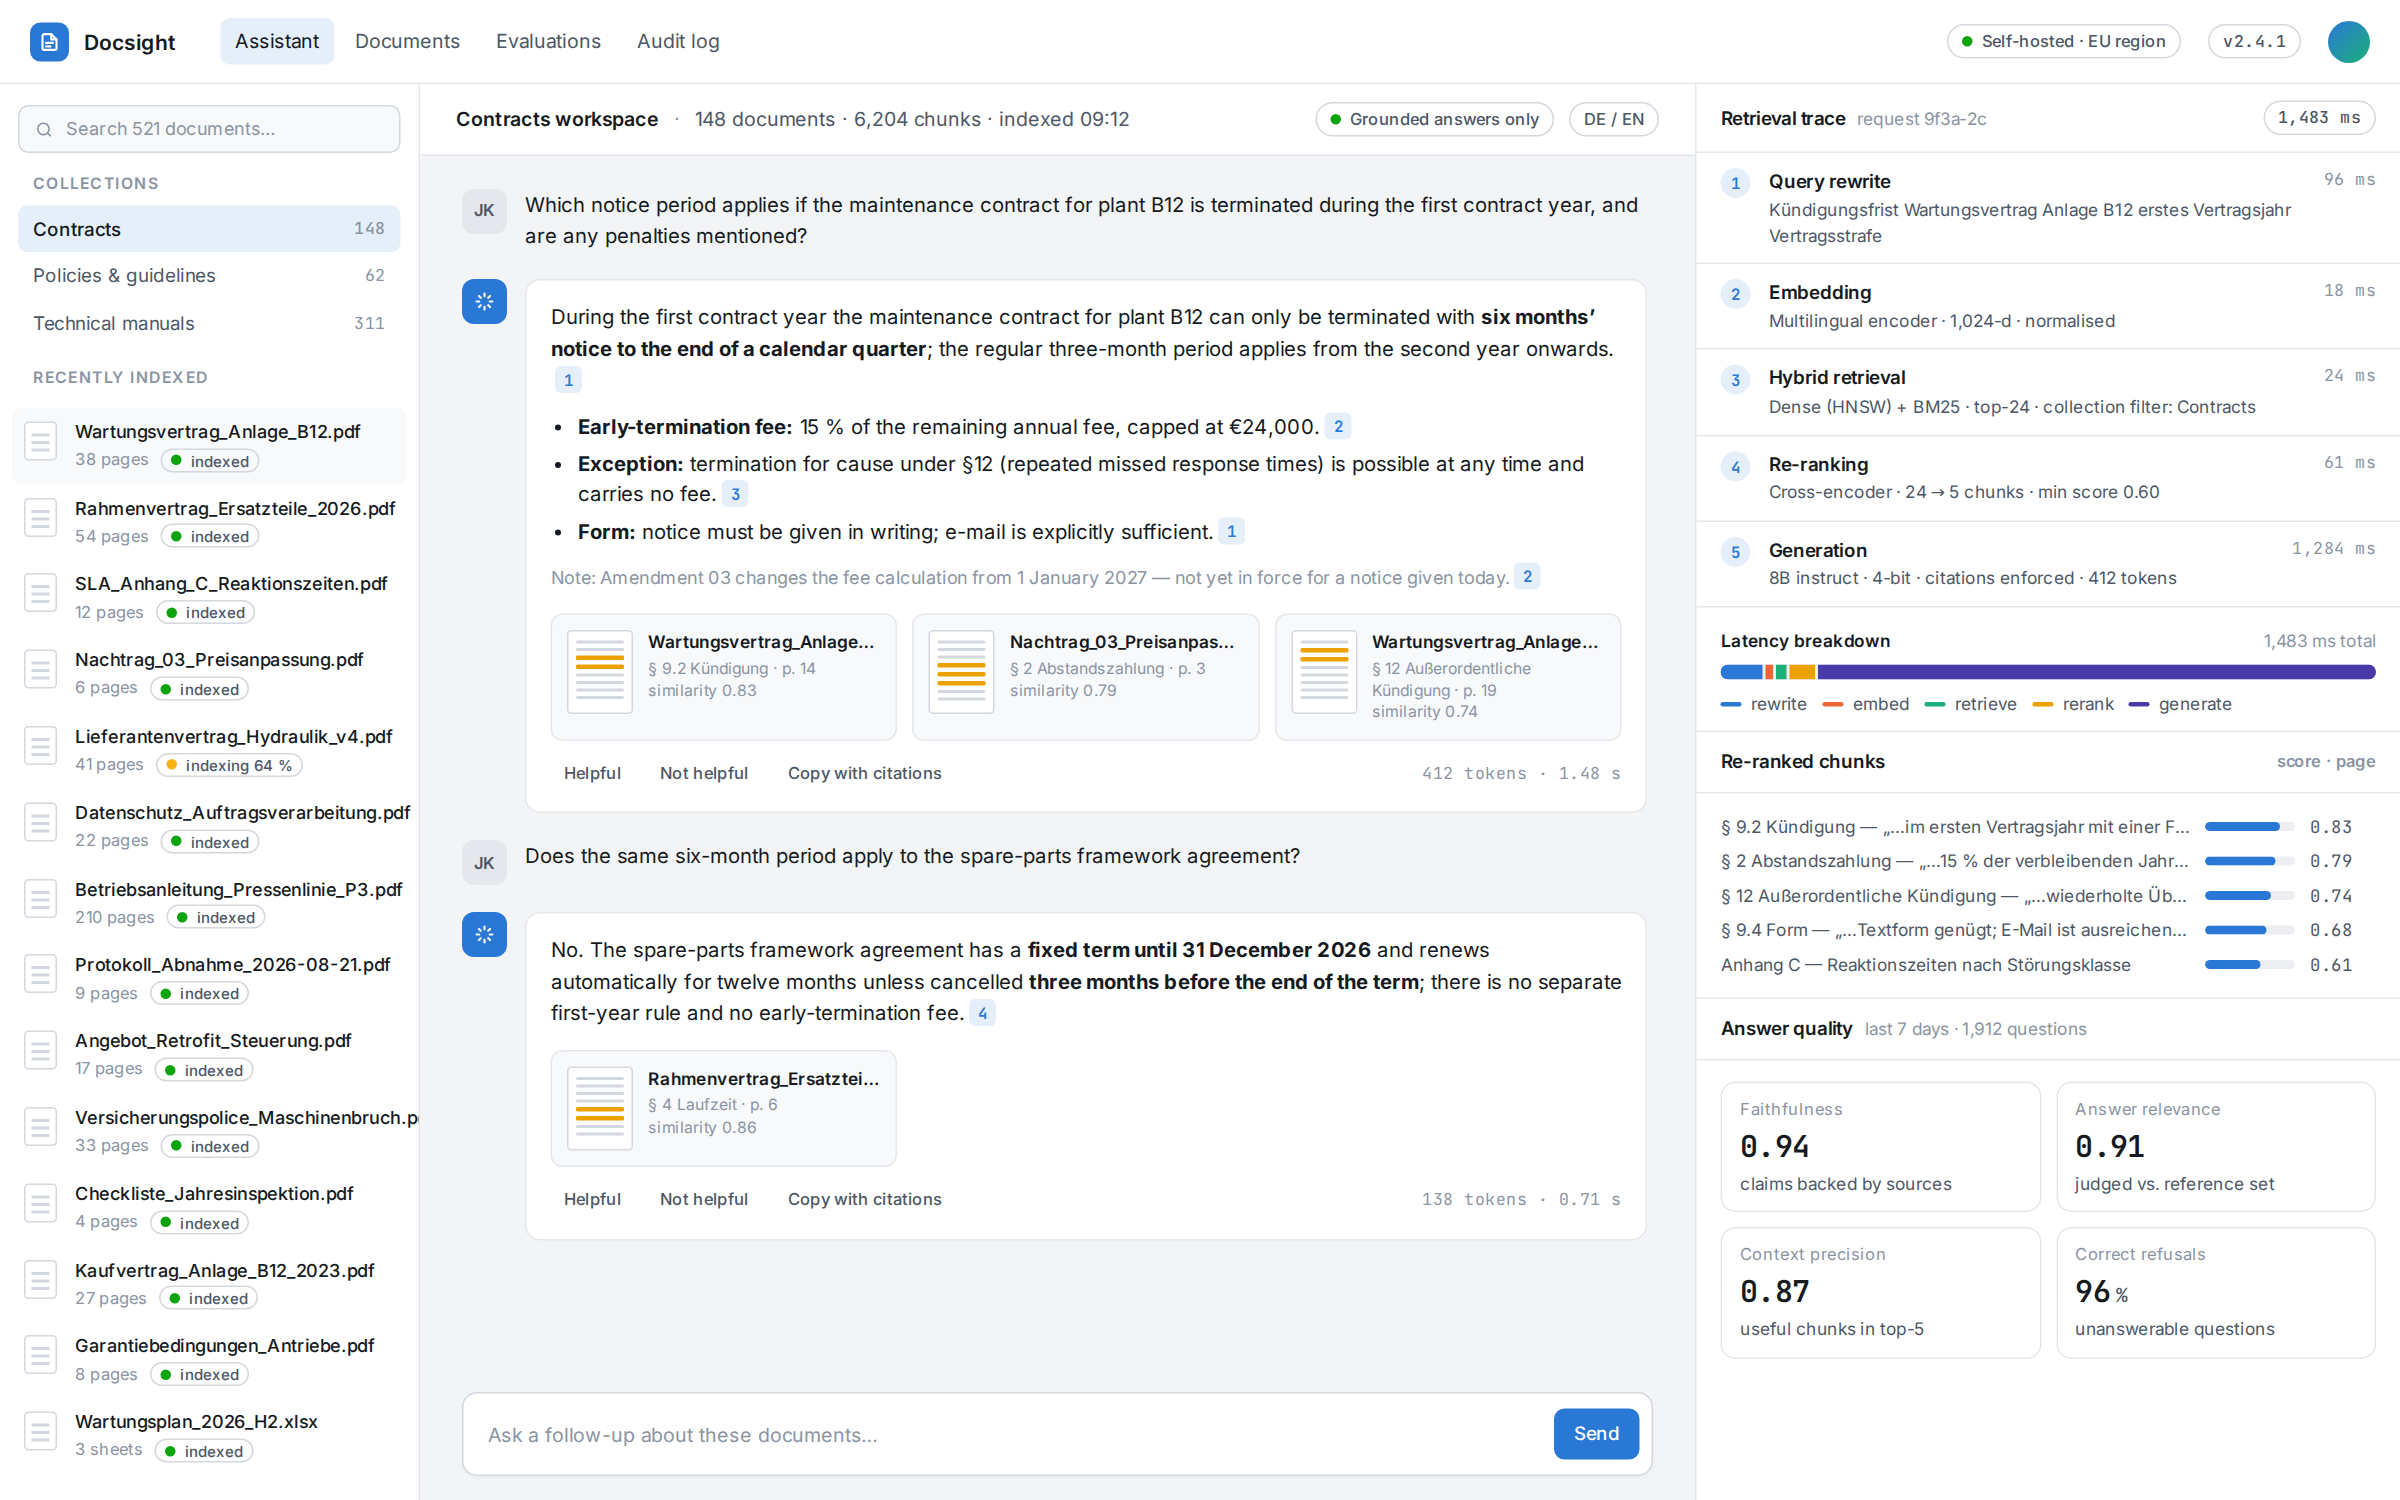
- Eine Ingestion-Pipeline, die PDFs, Tabellen und gescannte Dokumente (mit OCR) verarbeitet, sie entlang von Überschriften und Klauseln statt in festen Fenstern zerlegt und auf jedem Abschnitt Seiten- und Paragrafenbezug behält.
- Hybrides Retrieval: dichte mehrsprachige Embeddings für die Bedeutung, BM25 für exakte Begriffe wie Paragrafennummern, danach ein Cross-Encoder-Re-Ranker, der 24 Kandidaten auf die fünf relevanten eingrenzt.
- Generierung mit einem offenen 8B-Instruktionsmodell, auf 4 Bit quantisiert und auf einer einzelnen GPU in einem EU-Rechenzentrum betrieben. Der Prompt erzwingt nummerierte Belege; jeder Satz ohne Quelle wird verworfen, bevor er den Nutzer erreicht.
- Ein Retrieval-Trace neben jeder Antwort, damit Prüfende die umformulierte Anfrage, die betrachteten Abschnitte und die Latenz jeder Stufe nachvollziehen können.
Ergebnisse
Auf einem Evaluationsset mit 1.912 Fragen des Vertragsteams erreicht der Assistent 0,94 Faithfulness (Aussagen durch die zitierten Quellen gedeckt) und 0,91 Answer Relevance und lehnt 96 % der Fragen korrekt ab, die die Dokumente nicht beantworten können. Die mediane Antwortzeit liegt bei 1,5 Sekunden, und kein Dokument verlässt jemals das Firmennetz.
Dieselbe Pipeline indexiert inzwischen technische Handbücher: Eine Technikerin vor Ort stellt ihre Frage auf Deutsch und bekommt den passenden Absatz mit Seitenzahl – statt eines 200-seitigen PDFs.