
Die Ausgangslage
Ein Service-Center bearbeitet weit über tausend Anrufe pro Tag, und fast keiner davon war hinterher durchsuchbar. Agentinnen und Agenten tippten Notizen aus dem Gedächtnis, Qualitätsprüfungen erfassten einen von zweihundert Anrufen, und Cloud-Transkriptionsdienste schieden aus, weil die Aufnahmen Namen, Adressen und Zahlungsdaten enthalten.
Die Aufgabe: jeden Anruf auf Deutsch (und gelegentlich Englisch) präzise transkribieren, sämtliche Audiodaten im Haus behalten und aus den Transkripten etwas machen, mit dem eine Teamleitung arbeiten kann.
Was wir gebaut haben
- Ein Sprachmodell der Whisper-Familie, feinabgestimmt auf 600 Stunden freigegebener, anonymisierter Gesprächsaufnahmen – das halbierte die Wortfehlerrate bei regionalen Akzenten, Produktnamen und Auftragsnummern.
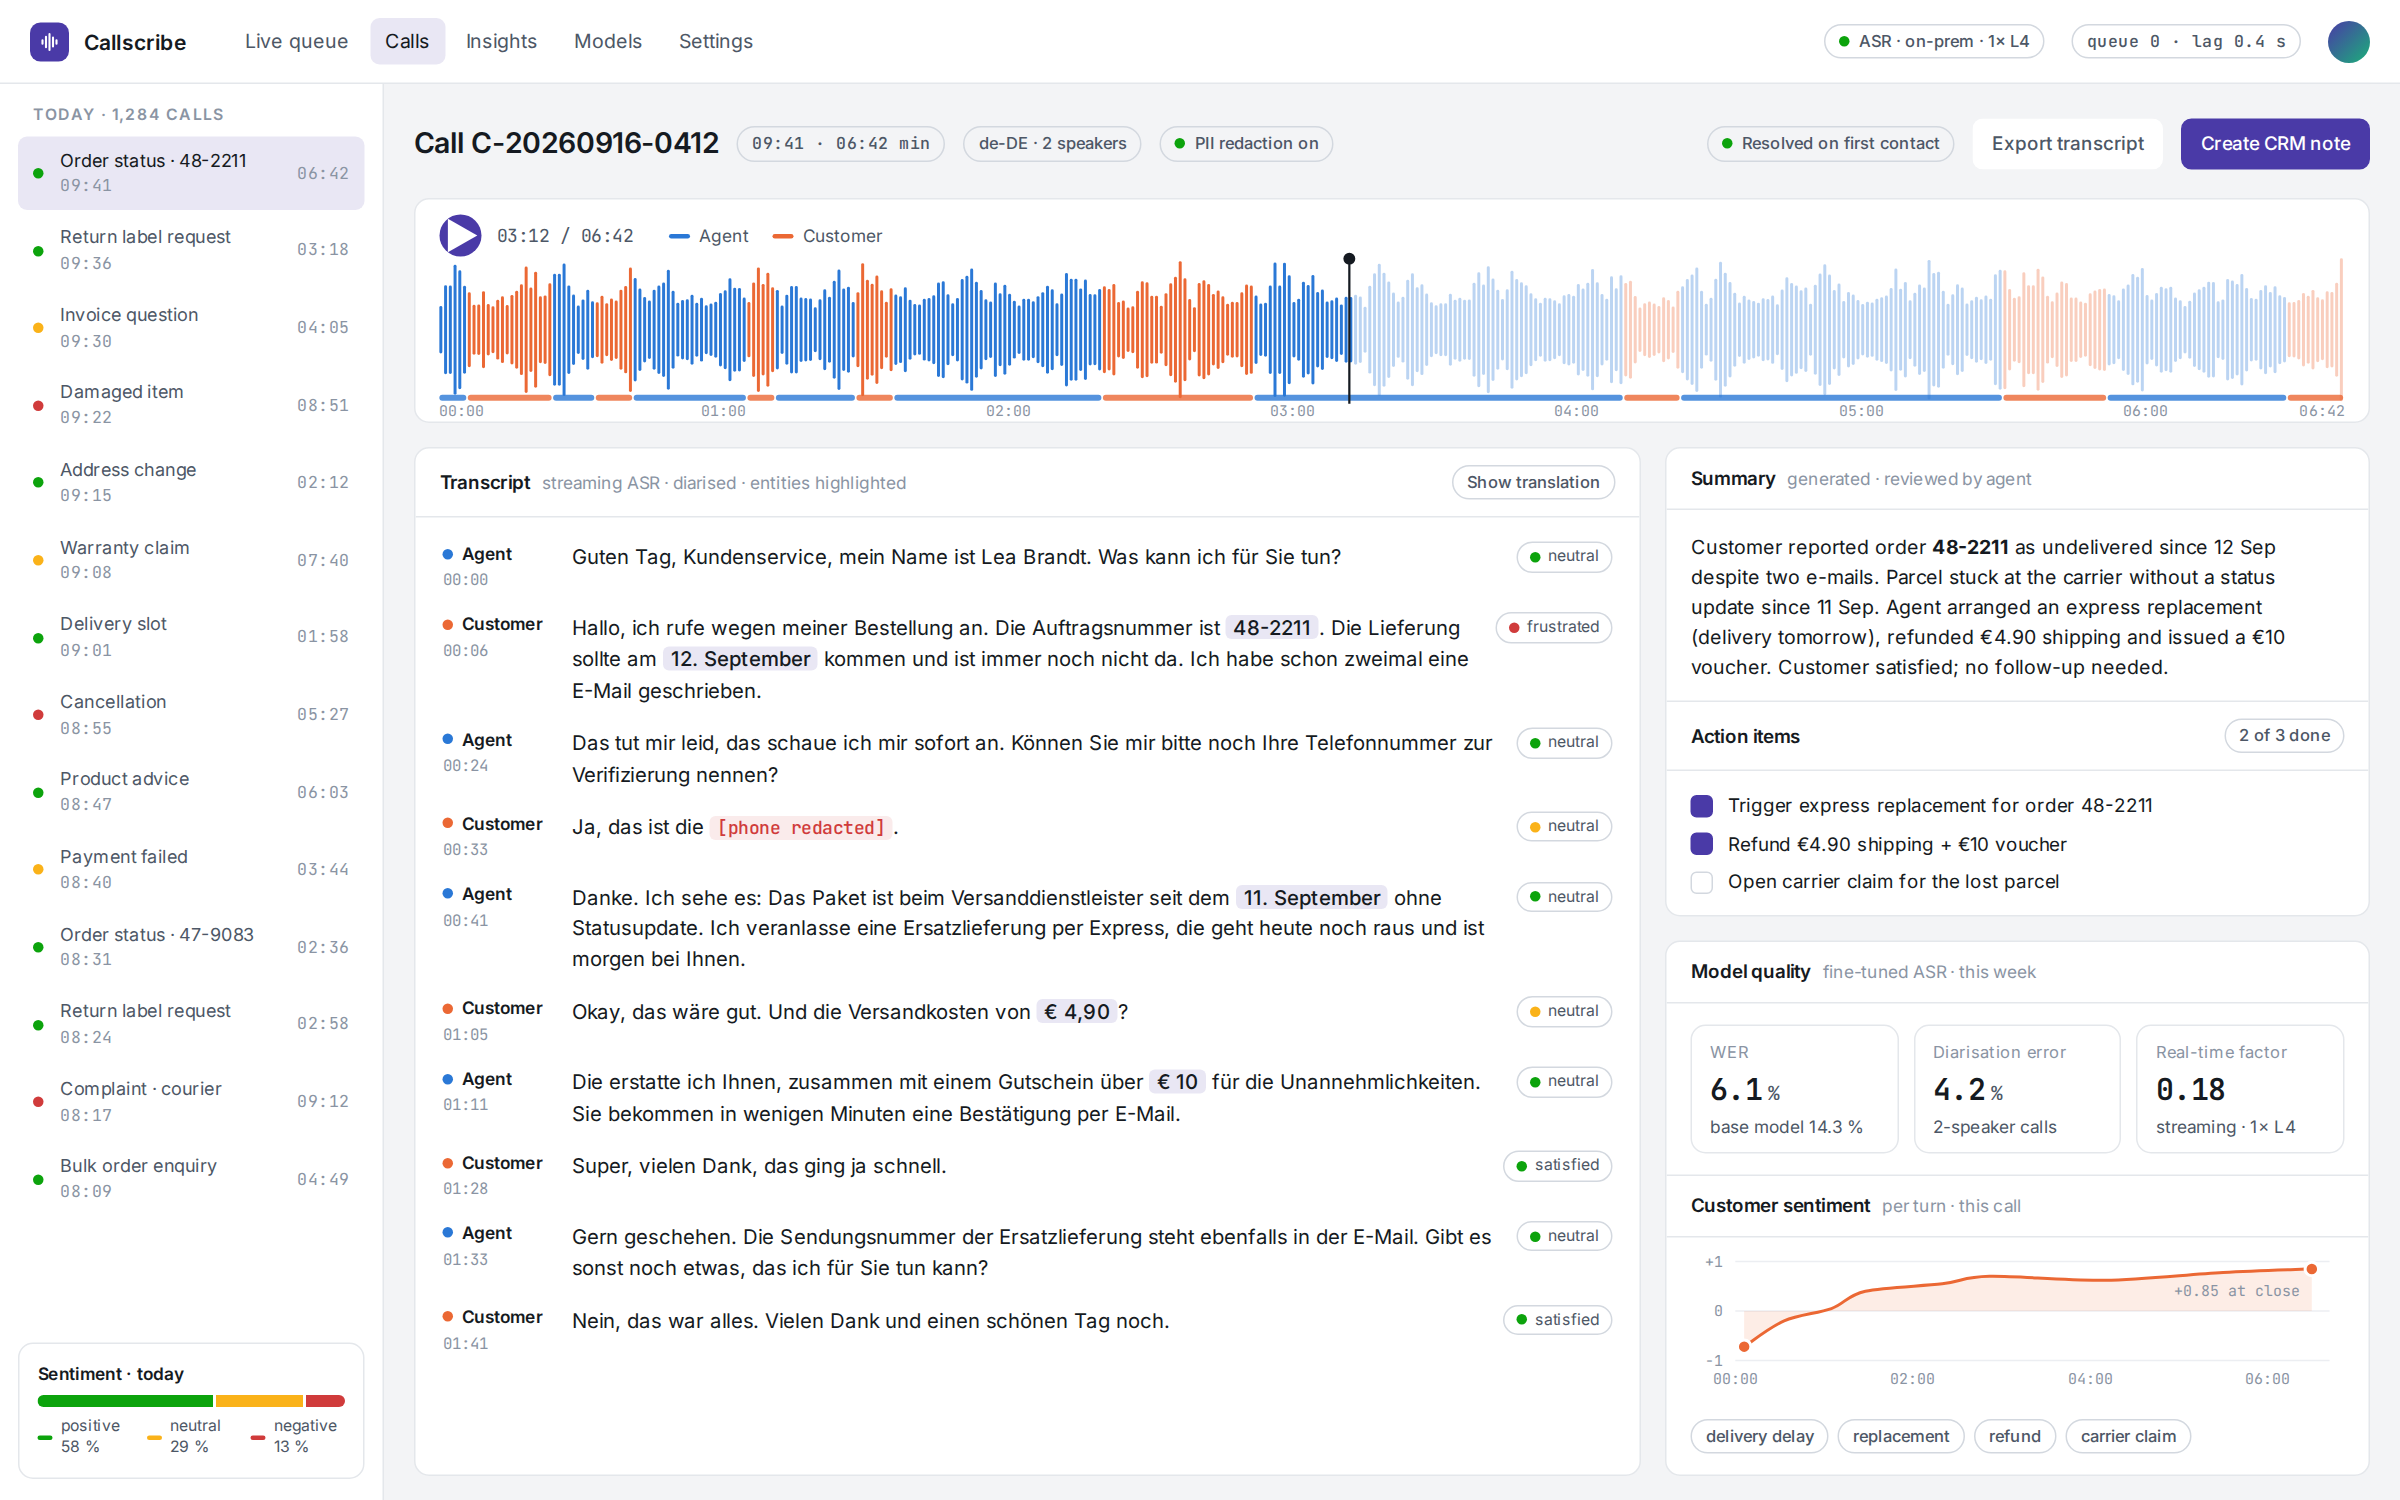
- Streaming-Inferenz mit Sprechertrennung, sodass das Transkript bereits während des Gesprächs erscheint und jede Zeile Agent oder Kunde zugeordnet ist.
- Eine Schwärzungsstufe, die Telefonnummern, Adressen, IBANs und Kartennummern im Transkript erkennt und ersetzt, bevor irgendetwas gespeichert wird.
- Ein kleines Sprachmodell, das für jeden Anruf Zusammenfassung, Aufgaben, Themen und eine Stimmungsbewertung je Gesprächsbeitrag erzeugt; die CRM-Notiz wird mit einem Klick bestätigt.
Ergebnisse
Das feinabgestimmte Modell erreicht auf zurückgehaltenen Anrufen eine Wortfehlerrate von 6,1 %, gegenüber 14,3 % beim Basismodell, bei einem Echtzeitfaktor von 0,18 – eine GPU der Mittelklasse hält mit dem gesamten Center Schritt. Die Nachbearbeitungszeit sank um rund 40 %, weil die Notizen fertig sind, bevor aufgelegt wird, und Qualitätsprüfungen erfassen jetzt jeden Anruf statt einer Stichprobe.
Stimmungstrends je Thema lieferten dem Team sein erstes Frühwarnsignal: Ein Problem mit einem Zustellpartner zeigte sich in den Gesprächsdaten zwei Tage, bevor es in der Beschwerdestatistik auftauchte.